
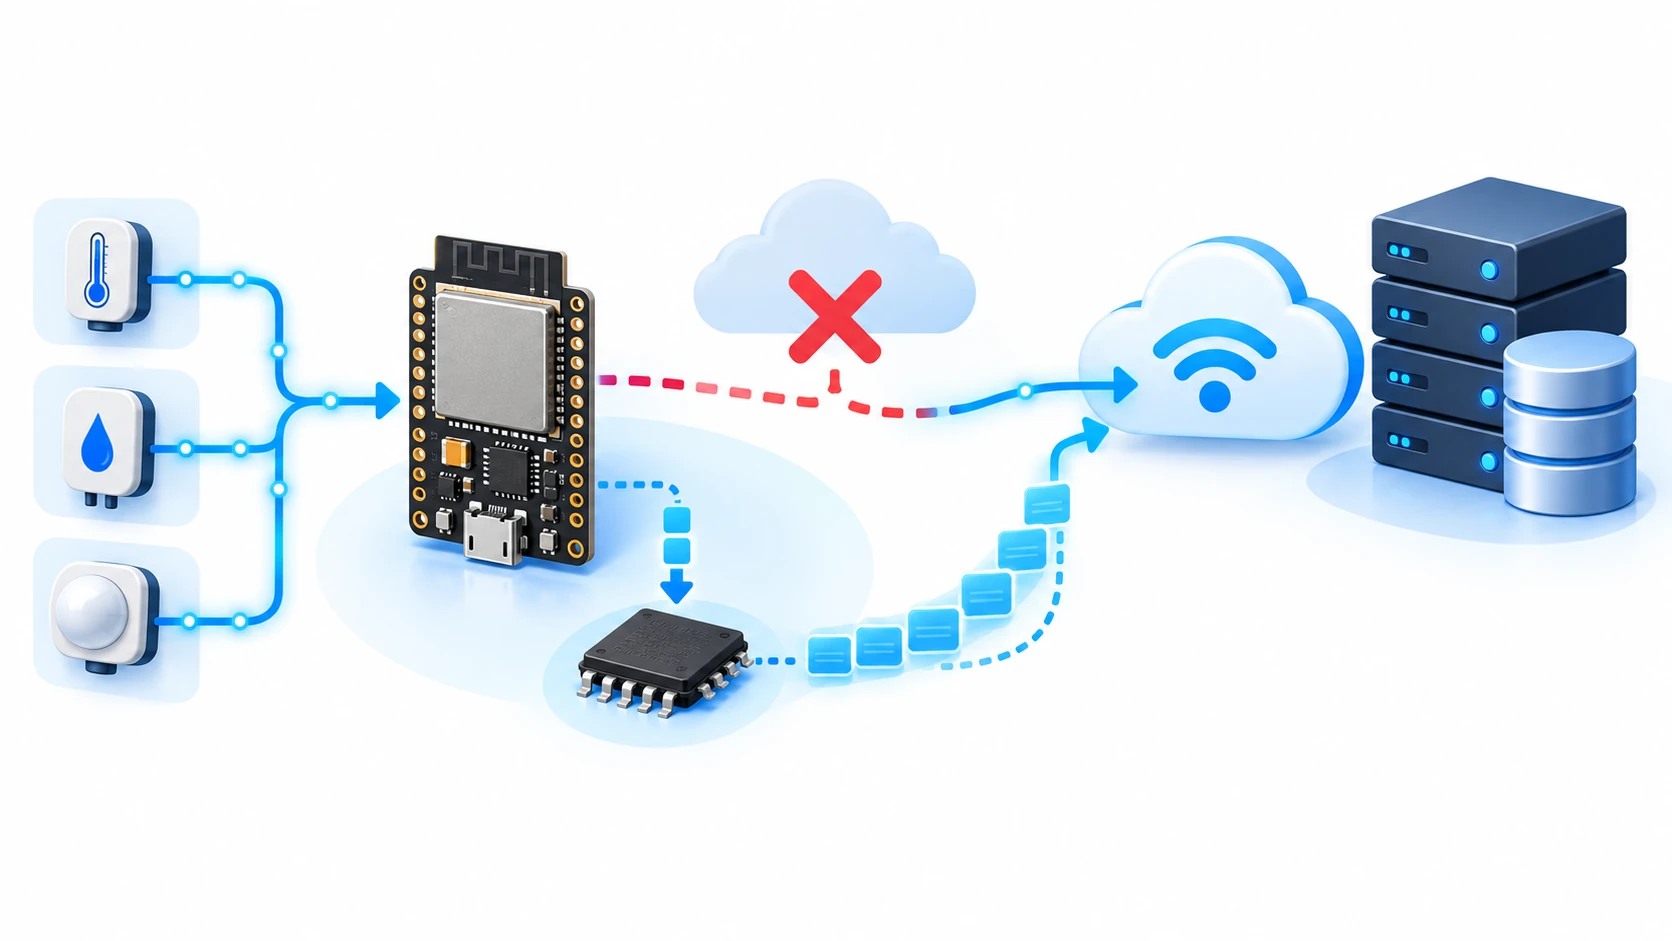
Buffer local en SPIFFS/LittleFS cuando cae la red
Guardar el dato cuando cae la red es fácil. Lo difícil es no destruir la flash, saber la hora y no saturar el broker cuando vuelve la conexión.
Requisitos de hardware:
- Placa ESP32 ou ESP32-S3
- Partição de sistema de arquivos no particionamento
- Rede Wi-Fi e um broker MQTT para o teste de reenvio
Descarga el material de este tutorial:
- Projeto completo (ZIP)159 KBFirmware Arduino com buffer circular em LittleFS, registro binário de 12 bytes, acúmulo em RAM por setor, carimbo de tempo relativo e reenvio em lotes. Partições, README e manual em PDF.
- Manual em PDF (8 páginas)189 KBAs contas de desgaste da flash, o carimbo de tempo sem relógio, descarte e confirmação, tabela de dimensionamento e checklist de catorze itens.
¿Quieres recibir nuevos manuales y esquemas industriales? Únete a nuestro canal de Telegram / WhatsApp
El dato existe y se pierde
Un gateway que lee un contador cada diez segundos y publica en la nube funciona bien hasta que se cae Internet. Entonces, durante cuarenta minutos, sigue leyendo y sigue descartando las lecturas. Cuando vuelve la red, el historial de ese periodo simplemente no existe.
Para un panel de temperatura es molesto. Para medir energía facturable, mantener la trazabilidad de un proceso o investigar por qué una máquina se detuvo a las tres de la madrugada, es inaceptable.
Store-and-forward lo resuelve: guardar localmente mientras no se puede enviar y enviar cuando se pueda. La idea es evidente. La implementación tiene tres trampas que casi ningún tutorial menciona, y este artículo trata sobre ellas.
Un búfer en RAM no basta
La primera tentación es guardar las lecturas en un vector en memoria. Es rápido, sencillo y no desgasta nada.
Pero se pierde al reiniciar. Sería tolerable si los reinicios fueran raros, pero las caídas de red y los reinicios ocurren juntos con una frecuencia incómoda: un corte de energía provoca ambos, el watchdog reinicia cuando algo se bloquea y una actualización OTA reinicia por definición.
En otras palabras, el búfer de RAM tiende a evaporarse justo cuando más importa.
La RAM sigue teniendo un papel, como verás en la sección siguiente. Solo que no puede ser el único lugar.
Desgaste de la flash: la restricción que decide el diseño
Esta es la trampa que separa un proyecto duradero de uno que muere en meses.
La flash del ESP32 soporta un número finito de ciclos de borrado por sector; el orden de magnitud habitual es de cien mil. La unidad de borrado es el sector completo de 4 KB, aunque solo hayas cambiado diez bytes.
Haz la cuenta con un registro por segundo, escrito directamente y sincronizado después de cada escritura. En la práctica es un borrado de sector por segundo. Cien mil segundos son poco menos de 28 horas.
Sistemas de archivos como LittleFS distribuyen el desgaste entre sectores y mejoran mucho el panorama. En una partición de 1 MB con 256 sectores, la misma cuenta da aproximadamente diez meses. Mejor, pero todavía inaceptable para un equipo industrial.
La solución no es escribir menos datos, sino escribir con menos frecuencia:
| 1 | acumula en RAM hasta llenar un sector (4 KB) |
| 2 | graba el bloque entero una vez |
| 3 | sincroniza una vez |
Con registros de 64 bytes, un sector contiene 64 lecturas. Grabar una vez por minuto en lugar de una vez por segundo reduce el desgaste por un factor de sesenta y la vida útil pasa de meses a décadas.
El precio es perder hasta un minuto de datos en un reinicio brusco. Compáralo con destruir la flash en diez meses y la elección resulta fácil. Si tu caso no tolera ni eso, el camino es una FRAM externa, que soporta órdenes de magnitud más ciclos.
Registro de tamaño fijo, no una línea JSON
La segunda tentación es grabar una línea JSON por lectura. Es legible y cómodo.
También es una trampa por tres motivos. El archivo crece sin límite, porque no puedes sobrescribir la línea más antigua sin reescribirlo entero. No puedes saltar directamente al registro N sin leer todo lo anterior. Y JSON utiliza de tres a cinco veces más bytes que la información que transporta, multiplicando el desgaste de la sección anterior.
Un registro binario de tamaño fijo resuelve los tres problemas:
| 1 | struct __attribute__((packed)) Registro { |
| 2 | uint32_t marcaTempo; |
| 3 | float valor; |
| 4 | uint16_t sequencia; |
| 5 | uint8_t origem; |
| 6 | uint8_t estado; |
| 7 | }; |
Doce bytes por lectura, siempre con el mismo tamaño. Esto permite calcular por multiplicación la dirección del registro N, sobrescribir el más antiguo sin tocar el resto y almacenar unas trescientas lecturas en cada sector de 4 KB.
El atributo packed importa: sin él, el compilador introduce relleno para alinear los campos y el tamaño del registro deja de ser el calculado.
El búfer circular
Con registros de tamaño fijo el búfer se convierte en un anillo: se escribe en la cabeza, se lee de la cola y ambos vuelven al principio al llegar al final.
| 1 | typedef struct { |
| 2 | uint32_t cabeca; |
| 3 | uint32_t cauda; |
| 4 | uint32_t total; |
| 5 | uint32_t marca; |
| 6 | } Indice; |
El índice también debe persistirse, o un reinicio hace perder la posición. Guárdalo en un archivo pequeño separado y no después de cada escritura, sino junto con el bloque en la misma sincronización.
La marca de validez cumple la misma función que en el artículo del watchdog: sin ella, un índice corrupto hace que el firmware lea basura como si fueran datos.
¿Descartar el más antiguo o el más nuevo?
Cuando el búfer se llena, algo se perderá. Cuál es una decisión de diseño y depende del dato.
Para telemetría continua, temperatura, corriente y presión, descarta el más antiguo. Si la red estuvo caída seis horas y el búfer solo guarda dos, prefieres las dos últimas horas a las dos primeras.
Para eventos y alarmas, lo contrario. Una alarma de sobrecarga no puede descartarse porque después llegó mucha telemetría. En ese caso lo correcto son dos búferes separados: uno circular grande para telemetría, que descarta lo más antiguo, y otro pequeño y protegido para eventos, que nunca descarta y avisa cuando se llena.
Mezclarlos en el mismo anillo garantiza que, en el peor momento, perderás precisamente el registro que explicaba el problema.
La marca de tiempo es el problema oculto
Este es el fallo que aparece después de que todo parece funcionar.
El dato guardado sin conexión debe llevar el instante en que se leyó, no el instante en que se envió. Si el servidor pone la marca al recibirlo, seis horas de búfer se convierten en seis horas de lecturas con la misma hora y el historial deja de servir.
El ESP32 no tiene reloj al encenderse. Obtiene la hora mediante NTP, que exige red, la misma red que se cayó.
El escenario completo es: se corta la energía, el dispositivo vuelve sin red y empieza a leer y guardar. No sabe qué hora es, pero aun así necesita marcar cada registro.
Guarda el tiempo relativo y conviértelo después:
| 1 | guarda millis() en el registro, junto con un contador de sesión |
| 2 | cuando NTP sincronice, calcula el instante real de sincronización |
| 3 | para cada registro: instante = referencia - (millisAhora - millisDelRegistro) |
Así los registros llevan la hora correcta aunque se hayan generado cuando no existía un reloj. El contador de sesión evita mezclar lecturas de antes y después de un reinicio, cuyos valores de millis no son comparables.
Es trabajo adicional. Sin él, el búfer entrega datos con la hora equivocada, lo que suele ser peor que no entregarlos.
Borra solo después de confirmar
Reenviar y borrar inmediatamente parece natural, pero pierde datos.
Si la conexión cae entre el envío y la confirmación, el registro se borró y nunca llegó. El orden correcto es: enviar, esperar la confirmación del broker y solo entonces avanzar la cola del búfer.
Con MQTT eso significa al menos QoS 1, porque el nivel 0 no confirma nada. También significa aceptar que el mismo registro puede llegar dos veces si se pierde la confirmación; de ahí el campo de secuencia, que permite al receptor descartar duplicados.
La regla profesional es: es mejor entregar dos veces que ninguna. Deduplicar en el servidor es trivial; recuperar un dato perdido es imposible.
Reenviar sin inundar la red
Cuando vuelve la red con seis horas acumuladas, la reacción ingenua es enviarlo todo lo más rápido posible.
Se rompen tres cosas. El broker puede aplicar un límite de tasa y cortar la conexión. El bucle principal queda atrapado reenviando y deja de leer el sensor, creando un hueco nuevo en el historial. El consumo máximo también puede provocar el brownout descrito en el artículo del watchdog.
Lo correcto es reenviar en lotes pausados, intercalados con el trabajo normal:
| 1 | en cada vuelta del bucle, envía como máximo N registros |
| 2 | después vuelve a leer el sensor y atender lo demás |
| 3 | si falla, detén el lote y espera la siguiente vuelta |
Veinte registros por vuelta, con el bucle ejecutándose diez veces por segundo, drenan doscientos por segundo. Seis horas de datos con una muestra cada diez segundos se vacían pronto sin bloquear nada.
Tutorial: de cero a un búfer que sobrevive
Paso 1: reservar espacio en el particionado
El búfer necesita una partición de sistema de archivos. Si ya seguiste el tutorial de OTA, su tabla reserva SPIFFS al final; es esa.
En una placa de 4 MB con OTA queda poco espacio. Dimensiona de forma consciente: con registros de 12 bytes, 512 KB guardan unas cuarenta mil lecturas.
Paso 2: definir el registro y calcular la capacidad
Elige los campos y suma los bytes. Después divide el tamaño de la partición por el tamaño del registro para saber cuántas lecturas caben y multiplica por el intervalo de lectura para saber cuántas horas de autonomía tienes.
Ese número es el que debes comunicar al operador. La autonomía del búfer es una especificación, no un detalle.
Paso 3: acumular en RAM antes de grabar
Implementa primero la acumulación y después la escritura. Con registros de 12 bytes, acumular 340 llena un sector de 4 KB.
Graba también cuando la acumulación supere un tiempo máximo; de lo contrario, un sensor lento dejaría datos en RAM durante horas sin protección.
Paso 4: grabar y probar la persistencia
Graba el bloque, sincroniza y reinicia la placa a propósito. Al volver, el firmware debe encontrar el índice, saber cuántos registros existen y continuar desde donde estaba.
Si vuelve a cero, el índice no se está guardando junto al bloque.
Paso 5: probar la vuelta del anillo
Reduce a propósito el tamaño de la partición o el límite de registros. Llena el búfer y sigue grabando.
El comportamiento correcto es sobrescribir los más antiguos sin hacer crecer el archivo ni corromper el índice. Confirma que el contador deja de aumentar cuando el anillo está lleno.
Paso 6: probar el reenvío con una caída de red
Acumula unos cientos de registros con el broker detenido. Arranca el broker y observa cómo se vacían los lotes.
En mitad del reenvío, detén el broker de nuevo. El búfer debe dejar de vaciarse sin perder lo que todavía no se confirmó y reanudar cuando vuelva el broker.
Esta es la prueba que demuestra la implementación. Si al final el número de registros entregados coincide con el número generado, está lista.
Errores comunes y cómo resolverlos
La flash murió en pocos meses. Se graba una vez por lectura en vez de una vez por bloque. Acumula en RAM y graba un sector cada vez.
El archivo crece hasta llenar la partición. Estás anexando en lugar de usar un búfer circular. Utiliza registros de tamaño fijo y sobrescribe el más antiguo.
Después de reiniciar el búfer está vacío. El índice no se persiste o se graba sin sincronización.
Todos los datos llegan con la misma hora. La marca se está poniendo al recibirlos. Guarda el tiempo relativo en el registro y conviértelo al enviar.
Faltan registros después de una caída durante el reenvío. Borras antes de confirmar. Avanza la cola solo después del reconocimiento del broker.
El broker corta la conexión cuando vuelve la red. El reenvío no tiene límite de tasa. Envía en lotes pausados.
El sensor deja de leerse durante el reenvío. El bucle está atascado vaciando el búfer. Limita cuántos registros salen en cada vuelta.
Se perdió una alarma importante y quedó telemetría. Los búferes están mezclados. Separa uno circular grande para telemetría y otro pequeño y protegido para eventos.