
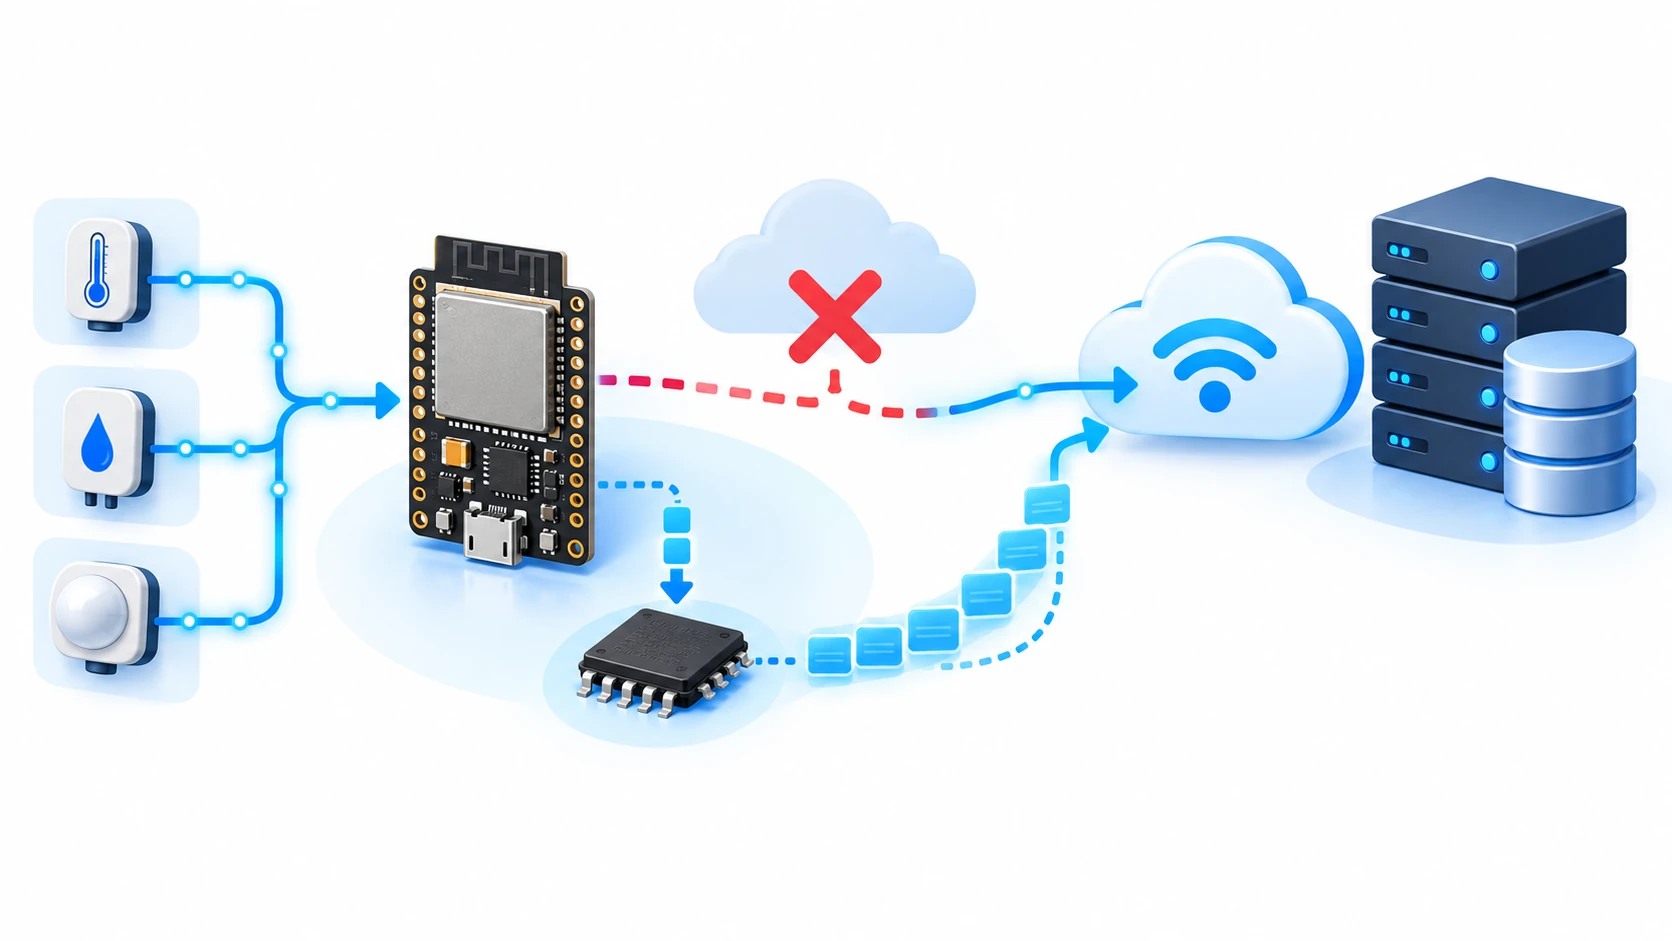
Buffer local na SPIFFS/LittleFS quando a rede cair
Guardar o dado quando a rede cai é a parte fácil. Difícil é não destruir a flash, saber que horas eram e não afogar o broker quando a rede volta.
Requisitos de hardware:
- Placa ESP32 ou ESP32-S3
- Partição de sistema de arquivos no particionamento
- Rede Wi-Fi e um broker MQTT para o teste de reenvio
Baixe o material deste tutorial:
- Projeto completo (ZIP)159 KBFirmware Arduino com buffer circular em LittleFS, registro binário de 12 bytes, acúmulo em RAM por setor, carimbo de tempo relativo e reenvio em lotes. Partições, README e manual em PDF.
- Manual em PDF (8 páginas)189 KBAs contas de desgaste da flash, o carimbo de tempo sem relógio, descarte e confirmação, tabela de dimensionamento e checklist de catorze itens.
Quer receber novos manuais e esquemas industriais? Entre no nosso canal do Telegram / WhatsApp
O dado existe, e se perde
Um gateway que lê um medidor a cada dez segundos e publica na nuvem funciona bem — até a internet cair. Aí, durante quarenta minutos, ele continua lendo e continua jogando fora. Quando a rede volta, o histórico daquele período simplesmente não existe.
Para um painel de temperatura, é chato. Para medição de energia faturável, para rastreabilidade de processo ou para investigar por que uma máquina parou às três da manhã, é inaceitável.
Store-and-forward resolve: guardar localmente enquanto não dá para enviar, e enviar quando der. A ideia é óbvia. A implementação tem três armadilhas que quase nenhum tutorial menciona, e é sobre elas que este artigo trata.
Buffer em RAM não basta
A primeira tentação é guardar num vetor na memória. É rápido, é simples, e não desgasta nada.
E se perde no reinício. O que seria tolerável se reinício fosse raro — mas a queda de rede e o reinício andam juntos com uma frequência incômoda: falta de energia derruba os dois, o watchdog reinicia quando algo trava, e uma atualização OTA reinicia por definição.
Ou seja: o buffer em RAM tende a evaporar exatamente na hora em que ele importava.
A RAM continua tendo papel, como você vai ver na próxima seção. Só não pode ser o único lugar.
Desgaste da flash: a restrição que decide o projeto
Esta é a armadilha que separa um projeto que dura de um que morre em meses.
A flash do ESP32 suporta um número finito de ciclos de apagamento por setor — a ordem de grandeza usual é cem mil. E a granularidade de apagamento é o setor inteiro, de 4 KB, mesmo que você tenha mudado dez bytes.
Faça a conta com um registro por segundo, gravado direto com sincronização a cada escrita. Isso é, na prática, um apagamento de setor por segundo. Cem mil segundos são pouco menos de 28 horas.
Sistemas de arquivos como o LittleFS distribuem o desgaste entre os setores, o que melhora muito o quadro. Numa partição de 1 MB, com 256 setores, a mesma conta dá algo próximo de dez meses. Melhor, e ainda assim inaceitável para um equipamento industrial.
A solução não é escrever menos dados. É escrever com menos frequência:
| 1 | acumule em RAM ate encher um setor (4 KB) |
| 2 | grave o bloco inteiro de uma vez |
| 3 | sincronize uma vez |
Com registros de 64 bytes, um setor comporta 64 leituras. Gravando uma vez por minuto em vez de uma vez por segundo, o desgaste cai por um fator de sessenta — e a vida útil sai de meses para décadas.
O preço é perder até um minuto de dados num reinício abrupto. Compare com destruir a flash em dez meses e a escolha fica fácil. Se o seu caso não tolera nem isso, o caminho é uma memória FRAM externa, que suporta ordens de grandeza mais ciclos.
Registro de tamanho fixo, não linha de JSON
A segunda tentação é gravar uma linha de JSON por leitura. É legível e conveniente.
E é uma armadilha por três motivos. O arquivo cresce sem limite, porque não há como sobrescrever a linha mais antiga sem reescrever o arquivo inteiro. Não dá para saltar direto para o registro N sem ler tudo o que veio antes. E o JSON gasta de três a cinco vezes mais bytes que a informação que carrega, o que multiplica o desgaste da seção anterior.
Registro binário de tamanho fixo resolve os três:
| 1 | struct __attribute__((packed)) Registro { |
| 2 | uint32_t marcaTempo; |
| 3 | float valor; |
| 4 | uint16_t sequencia; |
| 5 | uint8_t origem; |
| 6 | uint8_t estado; |
| 7 | }; |
Doze bytes por leitura, sempre no mesmo tamanho. Isso permite calcular o endereço do registro N por multiplicação, sobrescrever o mais antigo sem tocar no resto, e caber cerca de trezentas leituras em cada setor de 4 KB.
O atributo packed importa: sem ele o compilador insere preenchimento para alinhar os campos, e o tamanho do registro deixa de ser o que você calculou.
O buffer circular
Com registros de tamanho fixo, o buffer vira um anel: escreve-se na posição da cabeça, lê-se da cauda, e ambos dão a volta ao chegar no fim.
| 1 | typedef struct { |
| 2 | uint32_t cabeca; |
| 3 | uint32_t cauda; |
| 4 | uint32_t total; |
| 5 | uint32_t marca; |
| 6 | } Indice; |
O índice precisa ser persistido também, senão o reinício perde a noção de onde estava. Grave-o num arquivo separado e pequeno, e não a cada escrita — junto com o bloco, na mesma sincronização.
A marca de validade cumpre o mesmo papel do artigo de watchdog: sem ela, um índice corrompido faz o firmware ler lixo como se fosse dado.
Descartar o mais velho ou o mais novo?
Quando o buffer enche, alguma coisa vai ser perdida. Qual é decisão de projeto, e depende do dado.
Para telemetria contínua — temperatura, corrente, pressão — descarte o mais antigo. Se a rede ficou fora por seis horas e o buffer só guarda duas, você prefere as duas últimas horas às duas primeiras.
Para eventos e alarmes, o oposto. Um alarme de sobrecarga não pode ser descartado porque veio muita telemetria depois dele. Nesse caso o certo são dois buffers separados: um circular grande para telemetria, com descarte do mais antigo, e um pequeno e protegido para eventos, que nunca descarta e sinaliza quando enche.
Misturar os dois no mesmo anel garante que, no pior momento, você vai perder justamente o registro que explicava o problema.
O carimbo de tempo é o problema escondido
Aqui está a falha que só aparece depois que tudo parece funcionar.
O dado guardado offline precisa carregar o instante em que foi lido, não o instante em que foi enviado. Se o servidor carimba na chegada, seis horas de buffer viram seis horas de leituras com o mesmo horário, e o histórico fica inútil.
Só que o ESP32 não tem relógio ao ligar. Ele descobre a hora por NTP, que exige a rede — a mesma que caiu.
O cenário completo: falta energia, o dispositivo religa sem rede, começa a ler e a bufferizar. Ele não sabe que horas são. Mesmo assim precisa carimbar cada registro.
A saída é gravar o tempo relativo e converter depois:
| 1 | guarde millis() no registro, junto de um contador de sessao |
| 2 | quando o NTP sincronizar, calcule o instante real da sincronizacao |
| 3 | para cada registro: instante = referencia - (millisAgora - millisDoRegistro) |
Assim os registros carregam o horário correto mesmo tendo sido gerados quando o relógio não existia. O contador de sessão evita misturar leituras de antes e depois de um reinício, cujos valores de millis não são comparáveis.
É trabalho a mais. Sem ele, o buffer entrega dados com horário errado — o que costuma ser pior que não entregar.
Só apague depois de confirmar
Reenviar e apagar em seguida parece natural, e perde dado.
Se a conexão cair entre o envio e a confirmação, o registro foi apagado e nunca chegou. A ordem certa é: enviar, esperar a confirmação do broker, e só então avançar a cauda do buffer.
Com MQTT, isso significa qualidade de serviço 1 no mínimo, porque o nível 0 não confirma nada. E significa aceitar que o mesmo registro pode chegar duas vezes se a confirmação se perder — daí o campo de sequência no registro, que permite ao lado de lá descartar duplicata.
A regra do ofício: é melhor entregar duas vezes do que zero vezes. Deduplicar no servidor é trivial; recuperar dado perdido é impossível.
Reenvio sem afogar a rede
Quando a rede volta com seis horas de buffer acumulado, a reação ingênua é despejar tudo o mais rápido possível.
Três coisas quebram. O broker pode aplicar limite de taxa e derrubar a conexão. O laço principal fica preso no reenvio e para de ler o sensor, criando um novo buraco no histórico. E o consumo de pico pode provocar aquele brownout do artigo de watchdog.
O correto é reenviar em lotes pausados, intercalados com o trabalho normal:
| 1 | a cada volta do laco, envie no maximo N registros |
| 2 | depois volte a ler sensor e tratar o resto |
| 3 | se falhar, pare o lote e espere a proxima volta |
Vinte registros por volta, com o laço rodando dez vezes por segundo, escoam duzentos por segundo — seis horas de buffer a cada dez segundos se esvaziam em pouco tempo, sem travar nada.
Tutorial: do zero ao buffer que sobrevive
Passo 1: reservar espaço no particionamento
O buffer precisa de uma partição de sistema de arquivos. Se você já seguiu o tutorial de OTA, a tabela de lá reserva o spiffs no fim — é ele.
Numa placa de 4 MB com OTA, sobra pouco. Dimensione conscientemente: com registros de 12 bytes, 512 KB guardam cerca de quarenta mil leituras.
Passo 2: definir o registro e calcular a capacidade
Escolha os campos e some os bytes. Depois divida o tamanho da partição pelo tamanho do registro para saber quantas leituras cabem, e multiplique pelo intervalo de leitura para saber quantas horas de autonomia você tem.
Esse número é o que você deve informar a quem opera. Autonomia de buffer é especificação, não detalhe.
Passo 3: acumular em RAM antes de gravar
Implemente o acúmulo primeiro, e só depois a gravação. Com registros de 12 bytes, acumular 340 deles enche um setor de 4 KB.
Grave também quando o acúmulo passar de um tempo máximo — caso contrário, um sensor lento deixaria dados na RAM por horas, sem proteção.
Passo 4: gravar e testar a persistência
Grave o bloco, sincronize e reinicie a placa de propósito. Ao voltar, o firmware deve encontrar o índice, saber quantos registros existem e continuar de onde parou.
Se ele voltar zerado, o índice não está sendo persistido junto do bloco.
Passo 5: testar o giro do anel
Reduza o tamanho da partição, ou o limite de registros, para algo pequeno de propósito. Encha o buffer e continue gravando.
O comportamento correto é sobrescrever os mais antigos sem crescer o arquivo e sem corromper o índice. Confirme que a contagem para de subir quando o anel está cheio.
Passo 6: testar o reenvio com a rede caindo no meio
Acumule algumas centenas de registros com o broker parado. Suba o broker e observe o escoamento em lotes.
No meio do reenvio, derrube o broker de novo. O buffer deve parar de escoar sem perder o que ainda não foi confirmado, e retomar quando o broker voltar.
Esse é o teste que prova a implementação. Se ao final da bagunça o número de registros entregues bater com o número gerado, está pronto.
Erros comuns e como resolver
A flash morreu em poucos meses. Gravação por leitura em vez de por bloco. Acumule em RAM e grave um setor de cada vez.
O arquivo cresce até encher a partição. Você está anexando em vez de usar buffer circular. Registro de tamanho fixo e sobrescrita do mais antigo.
Depois do reinício o buffer volta vazio. O índice não está persistido, ou está sendo gravado sem sincronização.
Os dados chegam todos com o mesmo horário. O carimbo está sendo posto na chegada. Grave o tempo relativo no registro e converta na hora do envio.
Faltam registros depois de uma queda no meio do reenvio. Você apaga antes de confirmar. Avance a cauda só depois do reconhecimento do broker.
O broker derruba a conexão quando a rede volta. Reenvio sem limite de taxa. Envie em lotes pausados.
O sensor para de ser lido durante o reenvio. O laço está preso no escoamento. Limite quantos registros saem por volta.
Perdi um alarme importante e sobrou telemetria. Buffers misturados. Separe: circular grande para telemetria, pequeno e protegido para eventos.