
Cómo crear un copiloto de IA sin pagar una API: la arquitectura de este sitio
El copiloto del sitio no usa una API de IA de pago: funciona aislado y con login. Arquitectura de dos procesos y el error que casi inventó una respuesta.
Descarga el material de este tutorial:
- Kit de código de referência (ZIP)13 KBbridge-server.js, site-client.ts, unidade systemd de exemplo, README e o manual em PDF.
- Manual em PDF (7 páginas)13 KBAs duas camadas, o usuário dedicado, o bug do sandbox, quando essa arquitetura não é a certa, e checklist de implantação.
¿Quieres recibir nuevos manuales y esquemas industriales? Únete a nuestro canal de Telegram / WhatsApp
La pregunta que motivó este artículo
Si ya has conversado con el asistente de la esquina de esta página, has visto un copiloto de IA responder en segundos sobre placas, protocolos y código de ESP32. Cuando alguien pide ver «cómo se hizo», la pregunta casi siempre trae una suposición: «seguro que gastan una fortuna en llamadas a la API, ¿verdad?».
La respuesta es no. Este copiloto no hace una sola llamada a una API de IA de pago. Ejecuta un asistente de línea de comandos —el mismo tipo de herramienta que cualquier desarrollador usa para programar— autenticado mediante login, dentro de un proceso aislado del resto del sitio. Este artículo explica la arquitectura, incluido el bug que casi hizo que el copiloto inventara respuestas incorrectas con toda la confianza del mundo.
Por qué no hacer una llamada directa a una API de IA
El camino obvio para un chat de IA en un sitio web es: el visitante envía la pregunta, el servidor la reenvía a una API de IA en la nube y vuelve la respuesta. Es sencillo, es lo que muestra la mayoría de los tutoriales y funciona bien con poco volumen.
El problema aparece en la factura. Cada pregunta es una llamada cobrada por tokens, y un sitio de contenido técnico recibe visitas de personas que prueban los límites: preguntas repetidas, preguntas fuera del tema y curiosidad por ver hasta dónde llega el bot. Multiplica eso durante un mes y el coste deja de ser insignificante para un proyecto que no vende nada detrás del copiloto.
La alternativa que utiliza este sitio es ejecutar un asistente de IA ya autenticado mediante un login personal —sin cobro por llamada— y resolver con arquitectura el problema que eso crea: este tipo de herramienta fue diseñada para funcionar en tu terminal, con acceso amplio a tu máquina, no para recibir preguntas de desconocidos en internet.
El problema de seguridad que lo definió todo
El proceso principal de este sitio funciona con restricciones del sistema pensadas para contener un sitio público: sin permiso para escalar privilegios y sin acceso a partes del sistema que no le pertenecen. Ese es el comportamiento correcto para cualquier cosa expuesta a internet.
El conflicto es que un asistente de línea de comandos autenticado mediante login, para funcionar aislado del resto del servidor, necesita cambiar de usuario del sistema operativo antes de ejecutarse; y ese cambio de usuario es exactamente el tipo de operación que las restricciones del proceso principal bloquean deliberadamente.
La salida no fue relajar la restricción del sitio; ese tipo de decisión parece práctica y acaba siendo lo primero que explota un ataque. La salida fue sacar esa responsabilidad del proceso principal.
Las dos capas
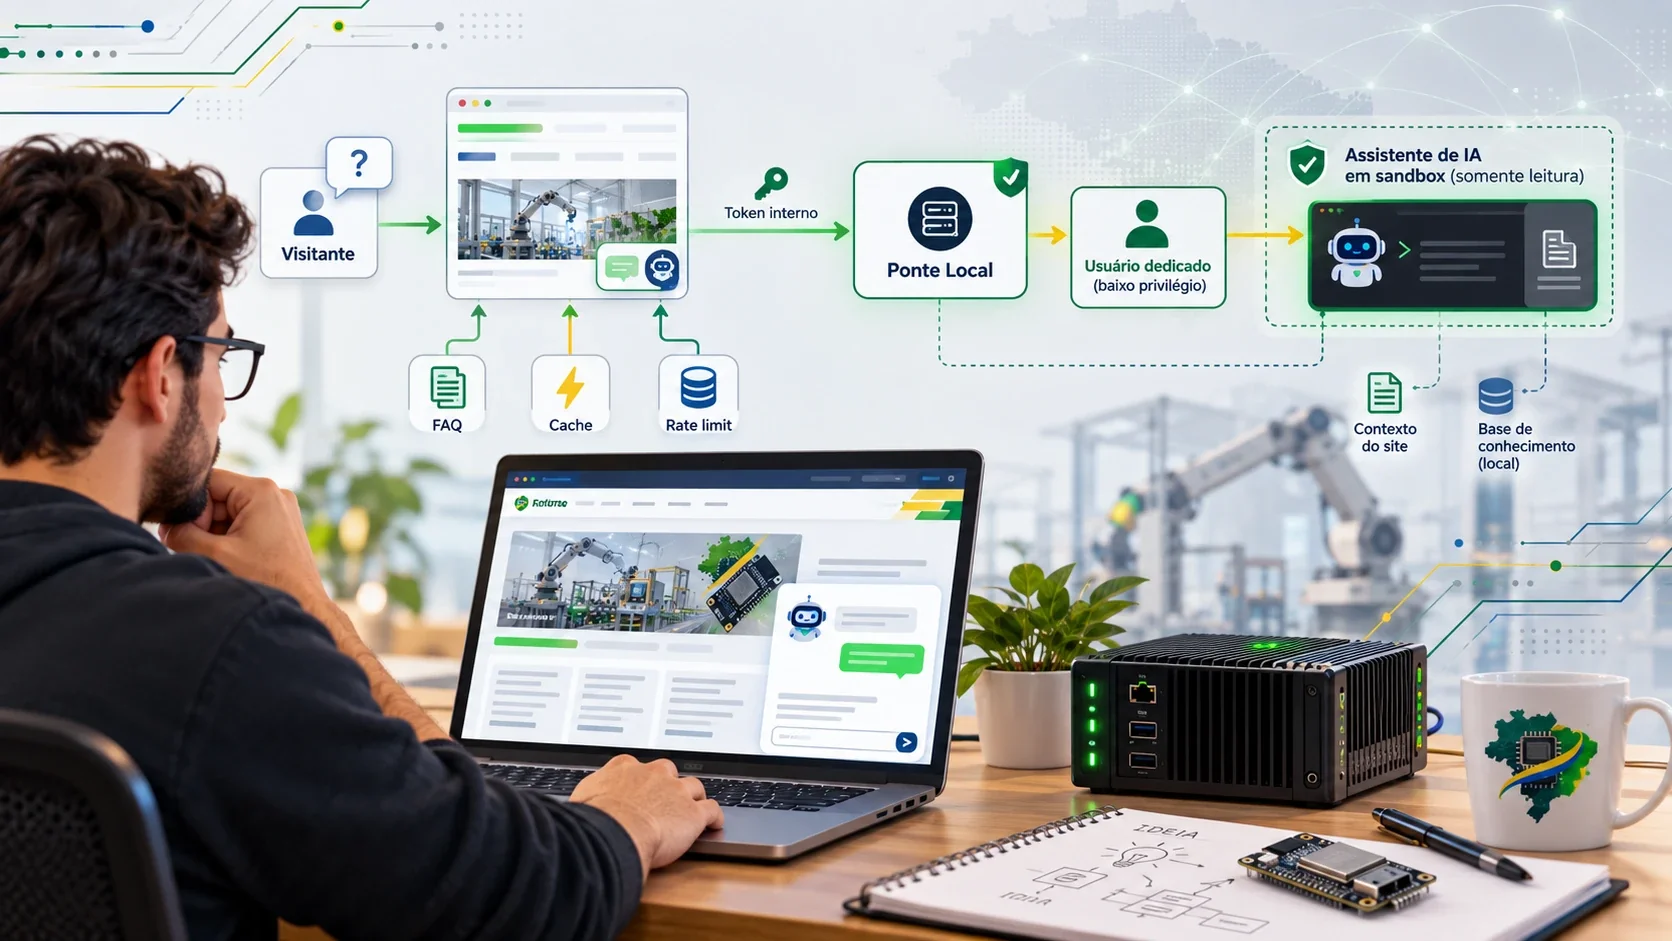
El copiloto vive en dos procesos separados que solo se comunican mediante una llamada interna:
1. El sitio. Recibe la pregunta del visitante, aplica límite de uso y caché, y la reenvía al segundo proceso. 2. El puente (bridge). Un servicio separado, sin las restricciones del sitio, que ejecuta el asistente de IA como un usuario del sistema dedicado solo a esa tarea; no tiene acceso a secretos del servidor ni escritura fuera de lo que necesita para sí mismo.
| 1 | Visitante → Sitio (Next.js) → llamada interna → Puente (proceso separado) |
| 2 | ↓ |
| 3 | usuario dedicado sin privilegios |
| 4 | ↓ |
| 5 | asistente de IA (sandbox de solo lectura) |
La llamada entre las dos capas es interna, solo se acepta desde la propia máquina y exige un token de autenticación propio; quien no tenga el token no puede hablar con el puente, aunque esté en la misma red.
El usuario que no tiene acceso a nada
La pieza que hace que esta separación valga la pena es el usuario dedicado: una cuenta del sistema creada solo para ejecutar el asistente de IA, sin shell interactivo, sin permiso de login y guardando únicamente la sesión autenticada de la herramienta. No puede ver los secretos del sitio ni escribir en ninguna carpeta fuera de la suya. Si se instruyera al asistente para hacer algo indebido, lo peor que podría alcanzar sería su propio espacio aislado.
Es el mismo principio de cualquier sandbox: no se trata de impedir que algo salga mal dentro, sino de garantizar que algo que salga mal dentro no signifique que ha salido mal en todo el sistema.
El bug que hacía que la IA inventara una respuesta en vez de avisar del error
Este es el tipo de defecto que solo aparece después de que todo parece funcionar. Se indicó al asistente que consultara los archivos internos del catálogo del sitio antes de responder preguntas sobre placas y tutoriales; en vez de responder «de memoria», debía leer primero el dato real.
Pero el sandbox de ejecución del asistente usa aislamiento de procesos internamente, y ese aislamiento necesita un tipo específico de socket de red solo para montar su propia interfaz de loopback interna; nada que salga a internet de verdad. Las restricciones de red del puente no incluían ese tipo de socket y el resultado fue que cada comando que intentaba ejecutar el asistente fallaba silenciosamente.
El efecto secundario fue el más peligroso posible: en vez de avisar «no pude leer el archivo», el modelo a veces rellenaba el hueco con una respuesta plausible pero incorrecta, por ejemplo la categoría equivocada de una placa. Fluida y convincente, pero falsa.
La corrección fue permitir explícitamente ese tipo de socket en la lista de restricciones del puente, sin abrir la red real. Pero el motivo de contar esta historia no es el detalle técnico, sino la advertencia: un sandbox demasiado restrictivo puede silenciar su propio error, y la única defensa es indicar al asistente que admita cuando no pudo confirmar algo, en vez de confiar en que siempre lo avisará por sí solo.
Caché y límite de preguntas
Sin control de uso, cualquier copiloto de IA se convierte en una forma cara —en tiempo, si no en dinero— de responder varias veces a la misma pregunta. Dos capas lo solucionan:
- Límite por visitante: un número máximo de preguntas por ventana de tiempo y dirección de origen, suficiente para una conversación real y demasiado corto para automatizar abusos.
- Caché de respuestas: las preguntas repetidas —y en un sitio público muchas se repiten casi palabra por palabra— no vuelven a llamar al asistente. La pregunta se normaliza (minúsculas, sin acentos y sin puntuación) y se usa como clave. En la medición de este sitio, la primera respuesta tarda la mayor parte de veinte segundos; la misma pregunta en la segunda solicitud vuelve en una fracción de segundo.
Una capa todavía más barata: responder sin llamar al modelo
Antes de activar el asistente de IA, el sitio intenta comparar la pregunta con una base propia de preguntas frecuentes, construida a partir del mismo contenido que ya existe en los tutoriales y conceptos. Cuando hay coincidencia, la respuesta llega en torno a cien milisegundos, sin cola, sin límite de uso y sin ningún coste de ejecución.
Esto no sustituye al asistente; sustituye la fracción de preguntas que ya tienen respuesta en algún lugar del sitio. Es la misma lógica de cualquier sistema de soporte: responder rápido lo que ya se sabe y reservar el procesamiento caro para lo que realmente lo necesita.
Memoria de la conversación
Una trampa común de esta arquitectura es que cada llamada al asistente queda aislada por defecto, sin recordar lo preguntado antes. Un «sí» o «puedes escribirlo» que confirma algo de la pregunta anterior llega al asistente sin contexto, y la conversación empieza desde cero en su cabeza, aunque el visitante vea todo el historial en pantalla.
La corrección es sencilla de describir y fácil de olvidar: enviar los últimos intercambios de la conversación junto con cada pregunta nueva, como parte de la entrada del asistente. Y cuando existe historial, saltarse también la caché, porque una respuesta que depende de lo dicho antes no se puede servir a otra persona que hizo la misma pregunta aislada.
Cuándo esta arquitectura no es la adecuada
Conviene mostrar el contrapunto, porque ninguna decisión de arquitectura sirve para todo:
Un login personal no es para un producto comercial de mucho tráfico. La autenticación mediante login está pensada para uso individual, no para servir a miles de visitantes simultáneos detrás de un único login. Superado cierto volumen, el camino correcto vuelve a ser una API de pago, con contrato y límites adecuados al uso comercial.
Aislar procesos da trabajo operativo. Dos servicios systemd, un usuario del sistema dedicado y un token sincronizado entre ambos son más piezas que mantener activas que una llamada HTTP directa a una API. Para un proyecto personal o un sitio de contenidos, el coste evitado puede compensar. Para un equipo pequeño sin tiempo de operación, puede no compensar.
El sandbox reduce el riesgo, pero no lo elimina. El bug del socket lo demuestra: incluso un aislamiento bien diseñado puede fallar de una forma que no estaba prevista. La defensa no es confiar ciegamente en el sandbox, sino combinar aislamiento con instrucciones claras para que el modelo admita la incertidumbre y probarlo antes de depender de él.
Continúa la conversación
Si quieres consultar un modelo de IA mediante una API desde un ESP32, en vez de alojar un copiloto en un sitio web, el camino y los costes están en Usar APIs públicas de IA desde ESP32. Y si te interesa usar un asistente de IA para escribir firmware, no para atender visitantes, el flujo que funciona está en Usar un asistente de IA para programar ESP32.
Y ya que has llegado hasta aquí: puedes preguntar al propio copiloto de este sitio por su arquitectura. Es el mismo asistente descrito en este artículo, respondiendo sobre sí mismo.
Configuración de platformio.ini:
| 1 | [Unit] |
| 2 | Description=Bridge do copiloto (processo isolado, sem privilegios do site) |
| 3 | |
| 4 | [Service] |
| 5 | User=eddy |
| 6 | ExecStart=/usr/bin/node /opt/bridge/server.js |
| 7 | # So aceita conexao da propria maquina — nunca exposto na internet |
| 8 | # Bind interno em 127.0.0.1, autenticado por token proprio |
| 9 | NoNewPrivileges=false |
| 10 | RestrictAddressFamilies=AF_UNIX AF_INET AF_INET6 AF_NETLINK |