
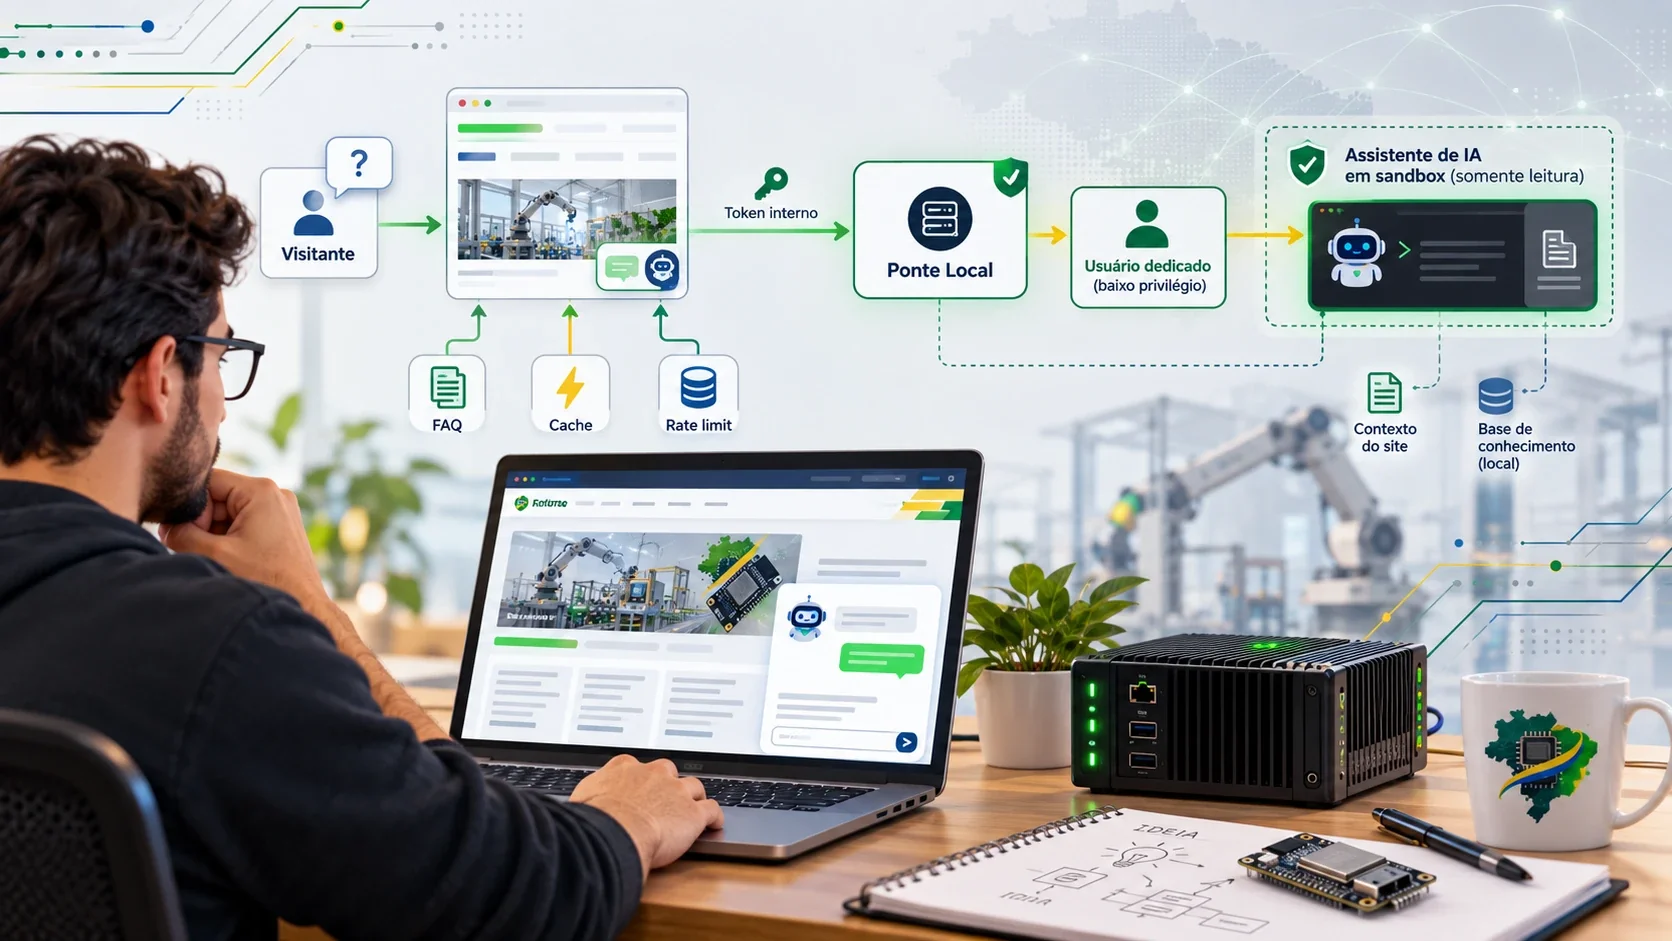
Como criar um copiloto de IA sem pagar por API: a arquitetura deste site
O copiloto deste site não chama API paga de IA — roda isolado, autenticado por login. A arquitetura de dois processos e o bug que quase inventou resposta.
Baixe o material deste tutorial:
- Kit de código de referência (ZIP)13 KBbridge-server.js, site-client.ts, unidade systemd de exemplo, README e o manual em PDF.
- Manual em PDF (7 páginas)13 KBAs duas camadas, o usuário dedicado, o bug do sandbox, quando essa arquitetura não é a certa, e checklist de implantação.
Quer receber novos manuais e esquemas industriais? Entre no nosso canal do Telegram / WhatsApp
A pergunta que motivou este artigo
Se você já conversou com o assistente no canto desta página, viu um copiloto de IA respondendo em segundos sobre placas, protocolos e código de ESP32. A pergunta que aparece quando alguém pede para ver "como foi feito" quase sempre vem com uma suposição embutida: "vocês devem estar gastando uma fortuna em chamada de API, né?"
A resposta é não. Este copiloto não faz uma única chamada para uma API paga de IA. Ele roda um assistente de linha de comando — o mesmo tipo de ferramenta que qualquer desenvolvedor usa para programar — autenticado por login, dentro de um processo isolado do resto do site. Este artigo é a arquitetura por trás disso, incluindo o bug que quase fez o copiloto inventar respostas erradas com toda a confiança do mundo.
Por que não uma chamada direta a uma API de IA
O caminho óbvio para um chat de IA num site é: o visitante manda a pergunta, o servidor repassa para uma API de IA na nuvem, a resposta volta. É simples, é o que a maioria dos tutoriais mostra, e funciona bem para volume baixo.
O problema aparece na conta. Cada pergunta é uma chamada cobrada por token, e um site de conteúdo técnico recebe visita de gente testando limites — perguntas repetidas, perguntas fora do assunto, gente curiosa vendo até onde o bot vai. Multiplique isso por mês e o custo deixa de ser desprezível para um projeto que não vende nada por trás do copiloto.
A alternativa que este site usa é rodar um assistente de IA já autenticado por login pessoal — sem cobrança por chamada — e resolver com arquitetura o problema que isso cria: esse tipo de ferramenta foi pensada para rodar no seu terminal, com acesso amplo à sua máquina, não para receber pergunta de estranho na internet.
O problema de segurança que definiu tudo
O processo principal deste site roda com um conjunto de restrições de sistema pensadas para conter um site público: sem permissão de escalar privilégio, sem alcançar partes do sistema que não sejam as dele. Isso é o comportamento correto para qualquer coisa exposta à internet.
O atrito é que um assistente de linha de comando autenticado por login, para rodar de forma isolada do restante do servidor, precisa trocar de usuário do sistema operacional antes de executar — e essa troca de usuário é exatamente o tipo de operação que as restrições do processo principal bloqueiam de propósito.
A saída não foi afrouxar a restrição do site — é o tipo de decisão que parece prática e vira a primeira coisa que um ataque explora. A saída foi tirar essa responsabilidade do processo principal.
As duas camadas
O copiloto vive em dois processos separados, que só se falam por uma chamada interna:
1. O site. Recebe a pergunta do visitante, aplica limite de uso e cache, e repassa para o segundo processo. 2. A ponte (bridge). Um serviço próprio, sem as restrições do site, que roda o assistente de IA como um usuário do sistema dedicado só a essa tarefa — sem acesso a segredo nenhum do servidor, sem escrita em lugar nenhum além do que ele mesmo precisa.
| 1 | Visitante → Site (Next.js) → chamada interna → Ponte (processo próprio) |
| 2 | ↓ |
| 3 | usuário dedicado, sem privilégio |
| 4 | ↓ |
| 5 | assistente de IA (sandbox só-leitura) |
A chamada entre as duas camadas é interna, aceita só de dentro da própria máquina, e exige um token de autenticação próprio — quem não tiver o token não fala com a ponte, mesmo estando na mesma rede.
O usuário que não tem acesso a nada
A peça que faz essa separação valer a pena é o usuário dedicado: uma conta de sistema criada só para rodar o assistente de IA, sem shell interativo, sem permissão de login, guardando apenas a sessão autenticada da ferramenta. Ele não enxerga os segredos do site, não escreve em nenhuma pasta além da própria, e se o assistente de IA for instruído a fazer algo indevido, o pior que consegue alcançar é o próprio espaço isolado dele.
É o mesmo princípio de qualquer sandbox: não é impedir que algo dê errado lá dentro, é garantir que dar errado lá dentro não signifique dar errado em nenhum outro lugar.
O bug que fazia a IA inventar resposta em vez de avisar erro
Este é o tipo de defeito que só aparece depois que tudo parece estar funcionando. O assistente foi instruído a consultar os arquivos internos do catálogo do site antes de responder perguntas sobre placas e tutoriais — em vez de responder "de memória", ele deveria ler o dado real primeiro.
Só que o sandbox de execução do assistente usa isolamento de processo por baixo dos panos, e esse isolamento precisa de um tipo específico de soquete de rede só para montar a própria interface de loopback interna — nada que saia para a internet de verdade. A restrição de rede da ponte não incluía esse tipo de soquete, e o resultado foi que todo comando que o assistente tentava rodar falhava silenciosamente.
O efeito colateral foi o mais perigoso possível: em vez de avisar "não consegui ler o arquivo", o modelo às vezes preenchia a lacuna com uma resposta plausível e errada — a categoria errada de uma placa, por exemplo. Fluente e convincente, e falsa.
A correção foi permitir explicitamente esse tipo de soquete na lista de restrições da ponte, sem abrir rede nenhuma de verdade. Mas o motivo de contar essa história aqui não é o detalhe técnico — é o alerta: um sandbox bom demais pode silenciar o próprio erro, e a única defesa é instruir o assistente a admitir quando não conseguiu confirmar algo, em vez de confiar que ele sempre vai avisar sozinho.
Cache e limite de perguntas
Sem controle de uso, qualquer copiloto de IA vira um jeito caro — em tempo, se não em dinheiro — de responder a mesma pergunta várias vezes. Duas camadas resolvem isso:
- Limite por visitante: um número máximo de perguntas por janela de tempo, por endereço de origem, suficiente para uma conversa real e curto demais para automatizar abuso.
- Cache de respostas: perguntas repetidas — e no agregado de um site público, muita pergunta se repete quase palavra por palavra — não chamam o assistente de novo. A pergunta é normalizada (minúscula, sem acento, sem pontuação) e usada como chave. Na prática medida aqui: a primeira vez que uma pergunta é feita, a resposta leva a maior parte de vinte segundos; a mesma pergunta na segunda vez volta em uma fração de segundo.
Uma camada mais barata ainda: responder sem chamar o modelo nenhum
Antes de acionar o assistente de IA, o site tenta casar a pergunta contra uma base de perguntas frequentes própria, construída em cima do mesmo conteúdo que já existe nos tutoriais e conceitos do site. Quando bate, a resposta sai em torno de cem milissegundos, sem fila, sem limite de uso e sem custo de execução nenhum.
Isso não substitui o assistente — substitui a fração das perguntas que já tem resposta pronta em algum lugar do site. É a mesma lógica de qualquer sistema de suporte: responder rápido o que já se sabe, e guardar o processamento caro para o que realmente precisa dele.
Memória de conversa
Uma armadilha comum nesse tipo de arquitetura: cada chamada ao assistente é isolada por padrão, sem lembrança do que foi perguntado antes. Um "sim" ou "pode escrever" confirmando algo dito na pergunta anterior chega ao assistente sem contexto nenhum, e a conversa reinicia do zero na cabeça dele — mesmo que o visitante veja o histórico inteiro na tela.
A correção é simples de descrever e fácil de esquecer: mandar as últimas trocas da conversa junto de cada nova pergunta, como parte do que é enviado ao assistente. E quando existe esse histórico, pular o cache — porque uma resposta que depende do que foi dito antes não pode ser servida para outra pessoa que fez a mesma pergunta isolada.
Quando essa arquitetura não é a certa
Vale colocar o contraponto, porque nenhuma escolha de arquitetura serve para tudo:
Login pessoal não é para produto comercial de alto tráfego. A autenticação por login foi pensada para uso individual, não para servir milhares de visitantes simultâneos por trás de um único login. Passado um certo volume, o caminho correto volta a ser uma API paga, com contrato e limite adequados ao uso comercial.
Isolar processo dá trabalho de operação. Dois serviços systemd, um usuário de sistema dedicado, um token para sincronizar entre eles — é mais peça para manter no ar do que uma chamada HTTP direta para uma API. Para um projeto pessoal ou um site de conteúdo, o custo evitado compensa. Para uma equipe pequena sem tempo de operação, pode não compensar.
Sandbox reduz risco, não elimina. O bug do soquete de rede é a prova: um isolamento bem-feito ainda pode falhar de um jeito que não estava no plano. A defesa não é confiar cegamente no sandbox — é combinar isolamento com instrução clara ao modelo para admitir incerteza, e testar isso na prática antes de confiar.
Continue a conversa
Se o que você quer é consultar um modelo de IA pela API a partir de um ESP32, e não hospedar um copiloto num site, o caminho e as contas estão em Usar APIs públicas de IA no ESP32. E se o seu interesse é usar um assistente de IA para escrever o firmware, não para atender visitante, o fluxo que funciona está em Usar assistente de IA para programar ESP32.
E já que você chegou até aqui: pode perguntar ao próprio copiloto deste site sobre a arquitetura dele. É o mesmo assistente descrito neste artigo, respondendo sobre si mesmo.
Configuração platformio.ini:
| 1 | [Unit] |
| 2 | Description=Bridge do copiloto (processo isolado, sem privilegios do site) |
| 3 | |
| 4 | [Service] |
| 5 | User=eddy |
| 6 | ExecStart=/usr/bin/node /opt/bridge/server.js |
| 7 | # So aceita conexao da propria maquina — nunca exposto na internet |
| 8 | # Bind interno em 127.0.0.1, autenticado por token proprio |
| 9 | NoNewPrivileges=false |
| 10 | RestrictAddressFamilies=AF_UNIX AF_INET AF_INET6 AF_NETLINK |